其他專案 · Selected Work · 2024 — Dynamic Removable Pattern Mining
增量資料庫可擦除樣式探勘
零售商想知道「哪些商品利潤太低、可以跟其他商品捆在一起賣」,但交易資料庫每天都在增長。 這個大學專題用 Java 物件導向設計實作了一套 可動態增加資料庫應用的樣式探勘演算法:新的銷售記錄進來時, 只需要針對新數據對原有結果的影響做調整,不必把整個資料庫重新計算一次。
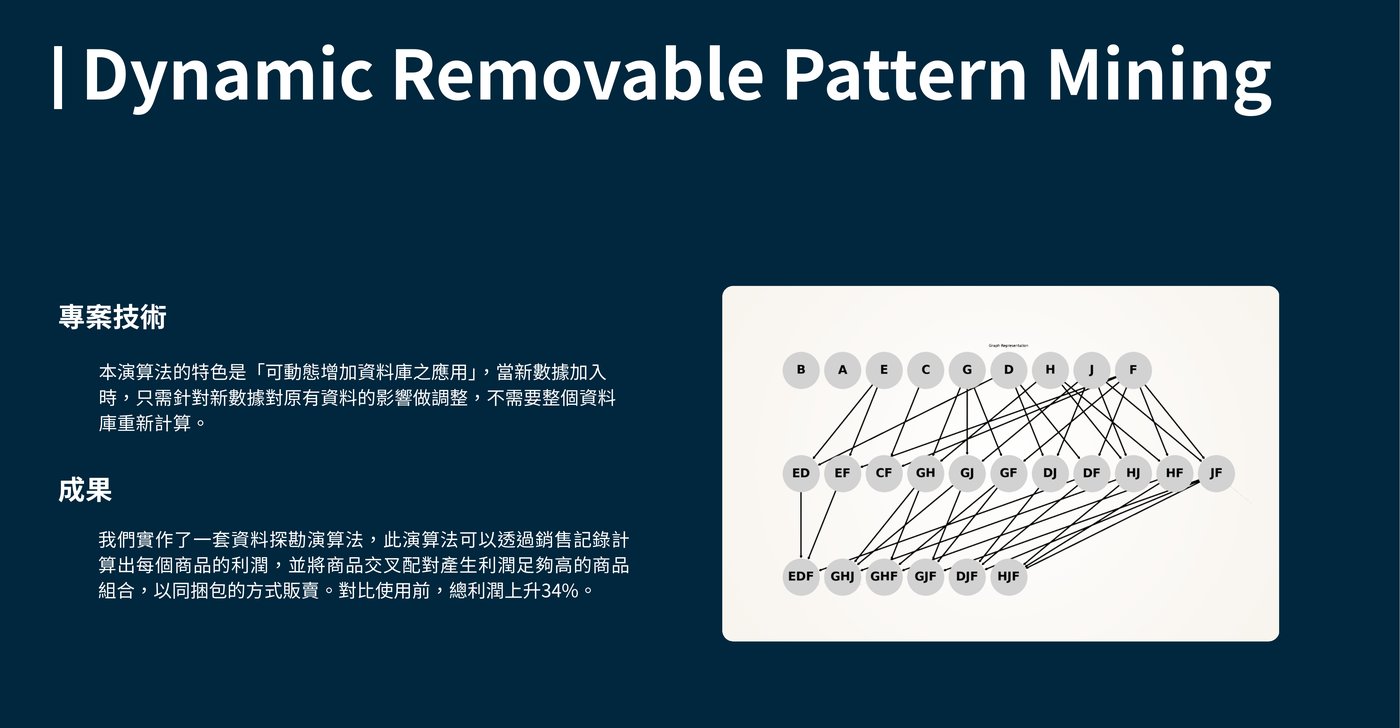
要解決的問題
零售商希望找出「單獨賣利潤很低、但如果跟某些商品一起賣就有利可圖」的商品組合—— 這在資料探勘裡屬於可擦除樣式探勘(Removable / Erasable Pattern Mining)的範疇: 反過來找出利潤貢獻偏低、值得整併或搭配銷售的商品集合, 幫零售商決定哪些商品該捆綁販賣、哪些該優先下架。
真實的零售交易資料是持續增量的,每天都有新的銷售記錄進來。 如果每次分析都要把整個資料庫重新掃描、重新計算一次,成本會隨資料量不斷疊加。 這個專案要解決的正是這件事:讓樣式探勘的結果可以隨新資料到來動態更新, 而不是每次都从零開始。
演算法設計:可動態增加資料庫的應用
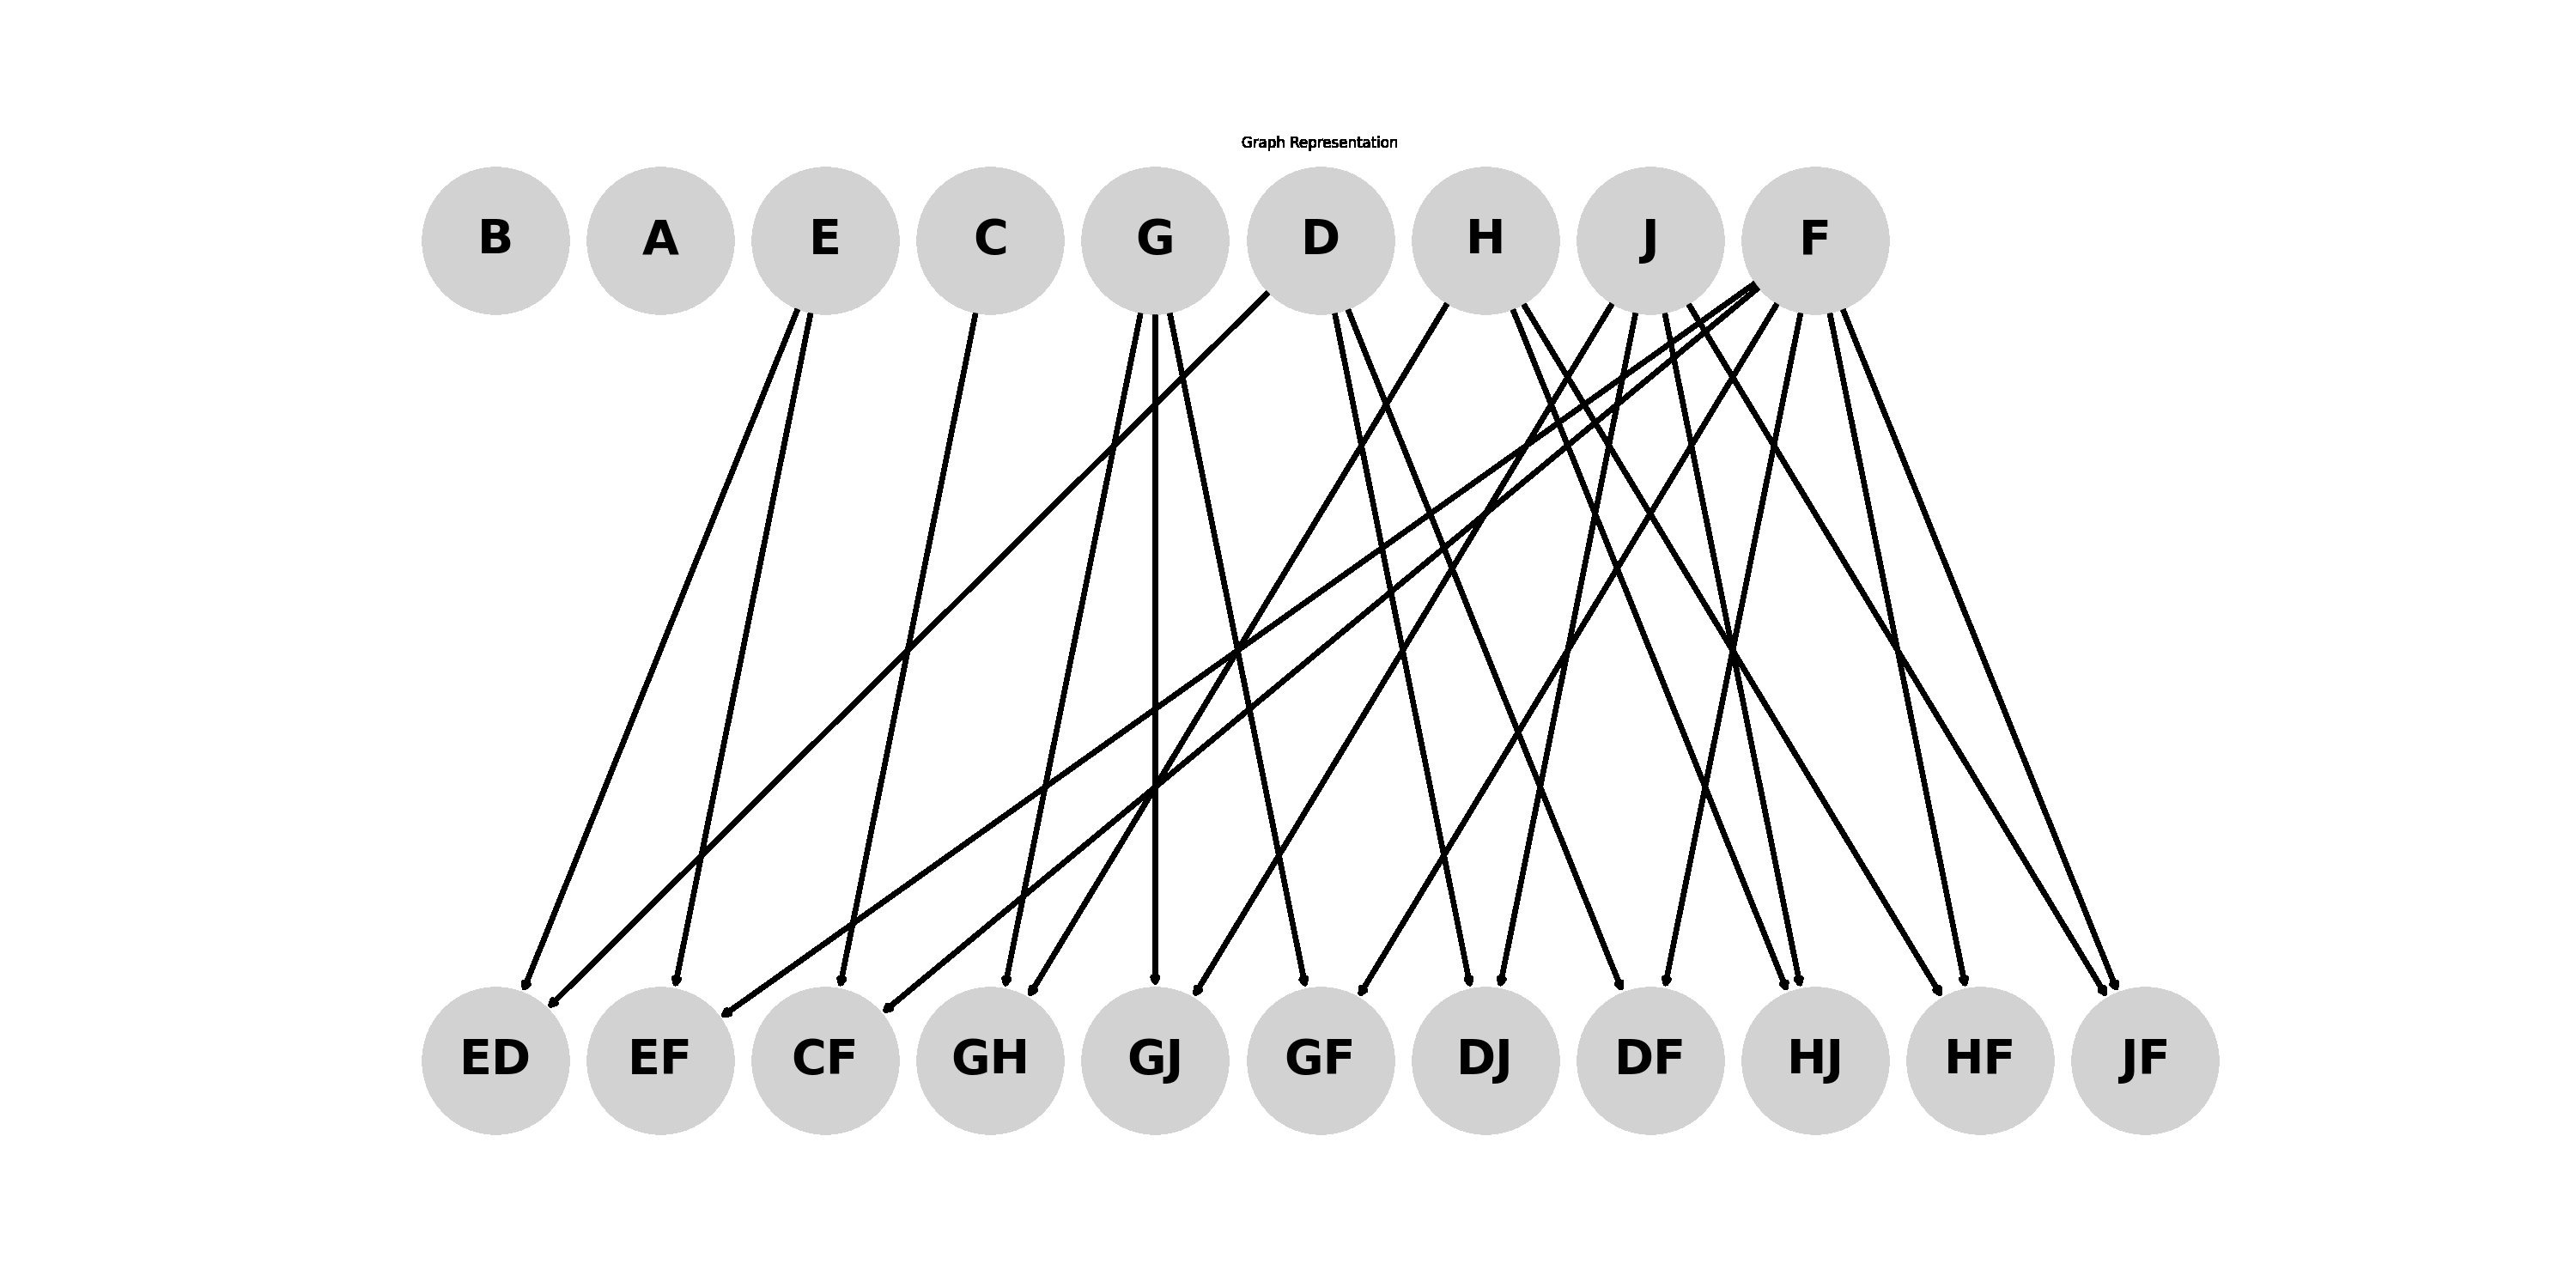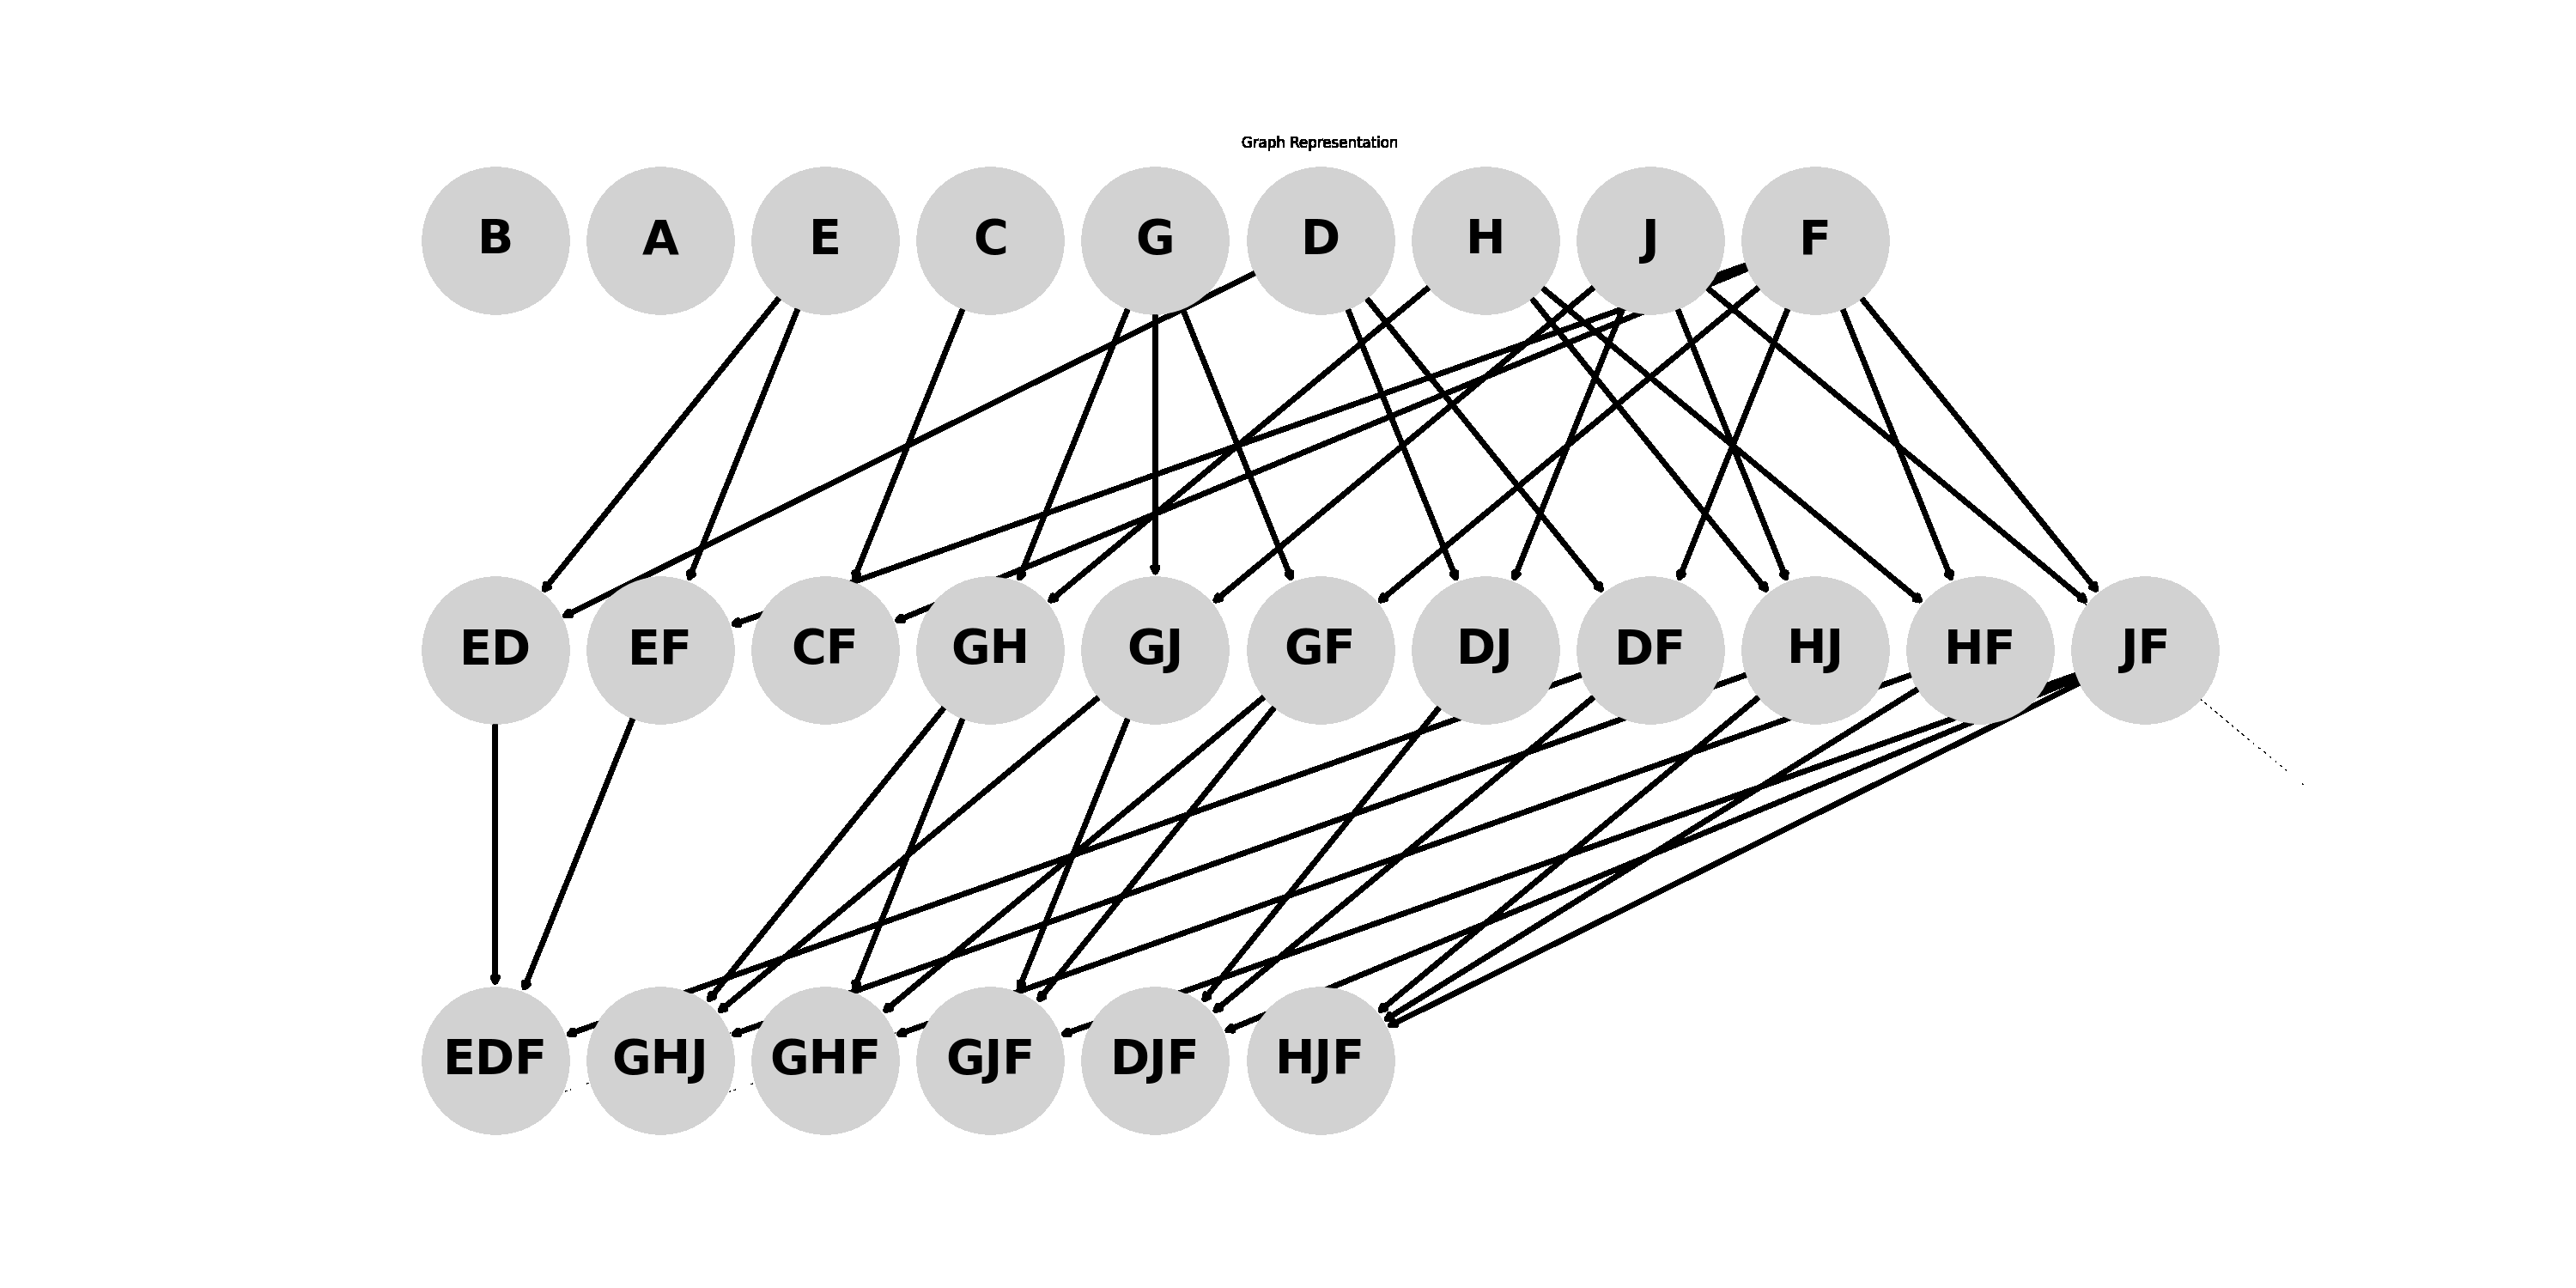
核心特色是「可動態增加資料庫之應用」:當新的銷售資料加入時, 演算法只需要針對新數據對原有資料的影響做調整, 不需要把整個資料庫重新計算一遍。候選商品組合以類似 lattice(格)的結構組織—— 從單一商品開始,逐步往上組成兩兩配對、三個一組的組合, 每一層都只需要根據下一層已經算好的結果延伸,而不是每次都重新窮舉。
每個候選樣式(pattern)都對應一個效用值(utility),由該商品組合在交易紀錄中 累積的利潤貢獻計算而來;低於門檻的樣式會被標記為「可擦除」。新交易加入時, 演算法只重新計算受影響節點的效用值,並視情況讓格結構往下一層擴張, 沒被新資料觸及的節點完全不用動。
Java 物件導向設計
整個系統用 Java 開發,刻意把「資料怎麼存」「效用怎麼算」「格結構怎麼長大」 這三件事拆成各自獨立的類別,而不是寫成一支從頭到尾的流程腳本:
- 交易資料層:負責讀取與封裝原始交易紀錄,跟後面的探勘邏輯完全解耦——資料來源要換格式,不用去動演算法本身。
- Pattern 節點物件:每個候選商品組合都是一個物件,自己保存商品集合、目前的效用值、是否已標記為可擦除,把「一個樣式該有的狀態」封裝在一起,而不是散落在陣列或雜湊表裡用索引拼湊。
- 增量更新邏輯:獨立成一個模組,只負責「新交易進來後要動哪些節點、格結構要不要長一層」,跟效用計算的細節切開,方便單獨測試正確性。
這樣拆分的好處是職責單一、容易單獨測試:要驗證「效用值算得對不對」跟 「增量更新有沒有漏掉受影響的節點」可以分開驗證,不用每次都跑一次完整流程才能抓到問題出在哪一層。
成果
我們實作了一套資料探勘演算法,能透過銷售記錄計算出每個商品的利潤, 並將商品交叉配對,找出利潤足夠高的商品組合,以同捆包的方式販賣。
候選樣式怎麼一層一層長出來
下面這張動畫示範了格結構實際擴張的樣子:一開始只有單一商品節點 (B、A、E、C、G、D、H、J、F),新交易讓某些商品開始一起出現後, 中間層的兩兩組合(如 ED、EF、GH)就會長出來;當交易資料裡 出現三個商品一起賣的紀錄,最下層的三商品組合 (如 EDF、GHJ、GJF)才會被建立。每一層都只根據上一層已經存在的節點延伸, 不會整個格重新算一遍。
學到的事:增量演算法真正的難點不在「怎麼算」,而在「怎麼確保只更新受影響的部分還能維持正確性」—— 商品組合的候選集合會隨新資料擴張或收斂,資料結構如果設計得不好, 「增量」就只是名義上的,實際上還是得把很多東西重算一次。把資料、狀態、更新邏輯用物件導向拆開, 是讓這件事真正可行、也可測試的關鍵。